Озвучка текста нейросетью: сервисы, цены и голос для видео в канал
Какие нейросети озвучивают текст в России в 2026 году, сколько стоит 1 000 знаков, какой голос выбрать, как исправить ударения и наложить голос на видео для канала.

В этой статье
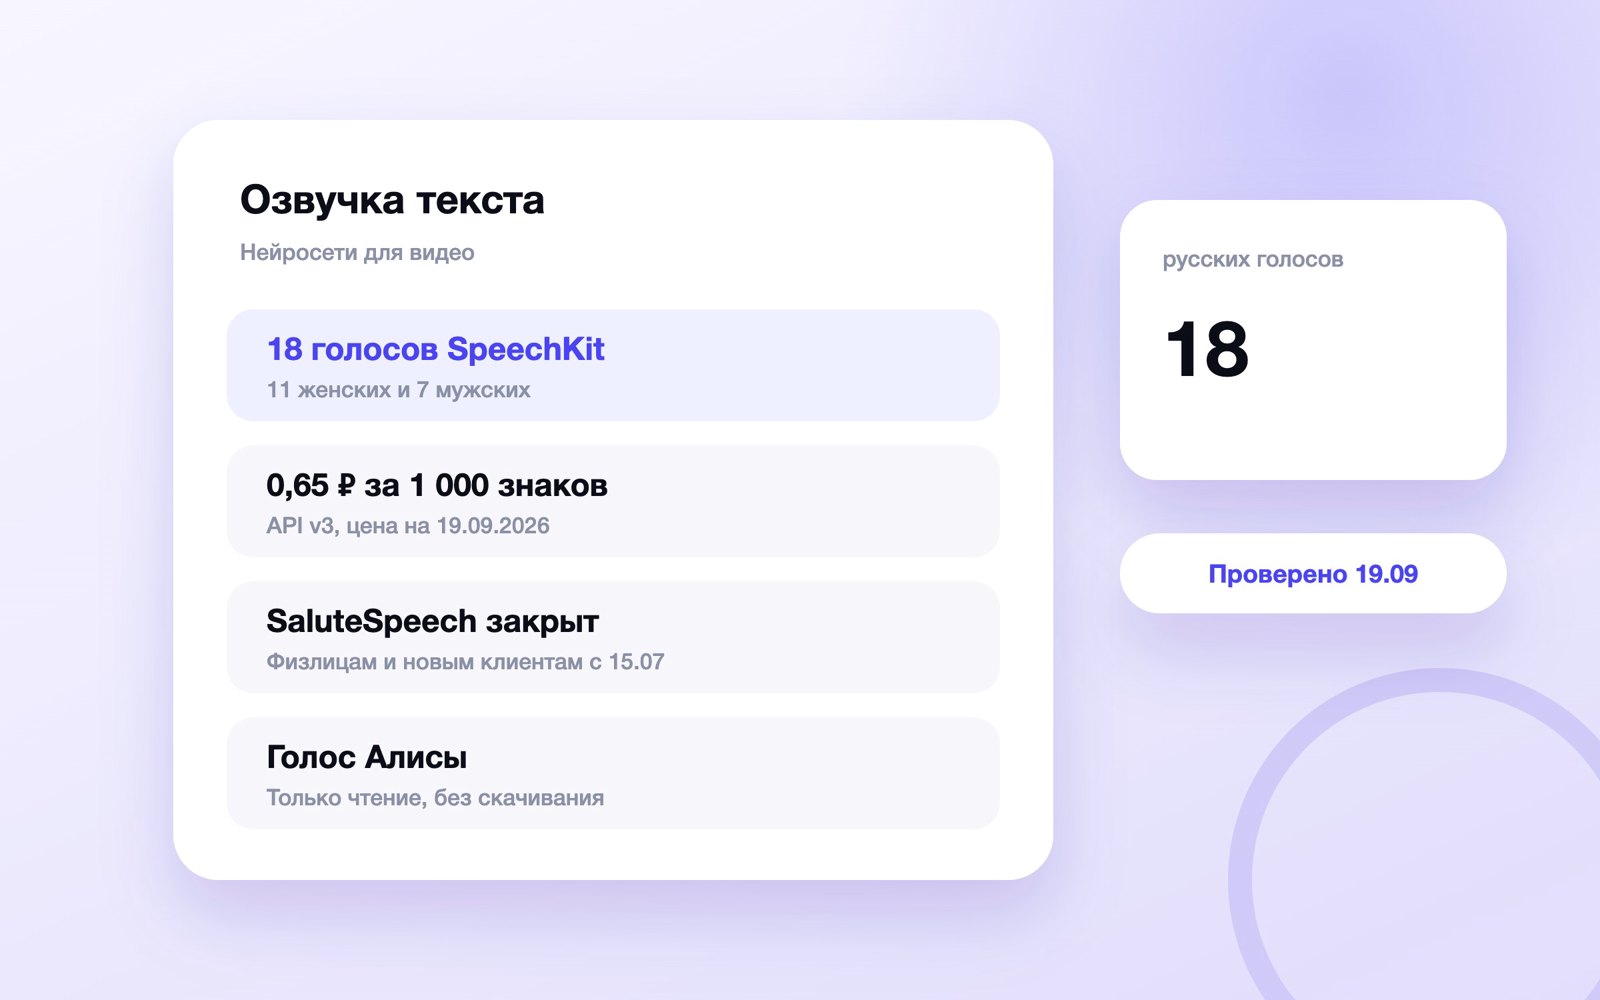
Коротко. Озвучка текста — это синтез речи: нейросеть читает текст выбранным голосом и отдаёт аудиофайл. Tapbox проверил 19.09.2026: в Yandex SpeechKit 18 русских голосов, 1 000 знаков стоят 0,65 ₽, а SaluteSpeech с 15.07.2026 не продаёт пакеты физлицам и новым клиентам.
Запрос «озвучка текста» по Вордстату в сентябре 2026 года набирает 208 тысяч показов в месяц, почти четверть — со словом «бесплатно». Автору канала голос нужен для короткого видео, аудиоверсии длинного поста или инструкции, которую удобнее слушать. Ниже — какие сервисы синтеза речи работают в России, сколько стоит минута ролика, какой голос выбрать, как исправить ударения и как донести ролик до канала в MAX. Цены и условия сверены 19 сентября 2026 года.
Что такое озвучка текста и как нейросеть превращает текст в голос
Озвучка текста (синтез речи, TTS — text-to-speech) — это преобразование написанного текста в звучащую речь программой. Вы даёте текст, выбираете голос и темп и получаете аудиофайл. В поиске то же самое называют «текст в голос онлайн» и «голос для видео».
Голос в синтезе — это модель, обученная на записях конкретного диктора, поэтому у голосов есть имена: marina, kirill, dasha. Амплуа — это характер произношения одного голоса: нейтральный, радостный, строгий, шёпот. Клонирование голоса — это создание модели по записям конкретного человека, например вашим. Обратная задача, из голоса в текст, называется распознаванием речи — внутри MAX она встроена, подробно в статье как перевести голосовое в текст в MAX.
Синтез хорош для голоса за кадром в коротком ролике, аудиоверсии поста, инструкций и новостей: фразу переделывают за минуту, а ровная подача без эмоций здесь только плюс. Для личной истории, извинения или отзыва он не годится — подписчик ждёт живого человека. Для рекламы «от лица» реального человека не годится тем более, о рисках ниже.
Какие нейросети для озвучки текста работают в России
Выбор уже, чем в подборках «топ-20 сервисов»: часть платформ продаёт синтез только компаниям, у Сбера доступ новым клиентам закрыт с лета. Что проверили 19.09.2026:
| Сервис | Кому доступен | Что важно знать |
|---|---|---|
| Yandex SpeechKit (AI Studio) | Любому с платёжным аккаунтом Yandex Cloud | 18 русских голосов, интерфейс без кода, 0,1626 ₽ за каждые 250 знаков |
| SaluteSpeech (Сбер) | Только прежним клиентам | С 15.07.2026 физлицам не продают пакеты и не продлевают Freemium, новым компаниям покупка закрыта |
| Audiogram (MWS AI, МТС) | Бизнесу по заявке | 4 готовых голоса и голос на заказ, цен на сайте нет |
| VoiceKit (Т-Банк) | Бизнесу | Стоимость синтеза «рассчитываем отдельно» |
| ElevenLabs | Не из России | Справка сервиса называет Россию среди стран с ограниченным доступом |
Про SaluteSpeech нужна оговорка: во многих обзорах он до сих пор бесплатный. На странице тарифов для физлиц написано: «С 15 июля 2026 года прекращена продажа новых пакетов и продление Freemium тарифа для физических лиц». Раньше Freemium давал 200 000 знаков синтеза в месяц, теперь им пользуются только те, у кого он ещё не истёк.
Сайты и боты «озвучка онлайн бесплатно» — чаще посредники поверх тех же движков. Перед рекламным роликом найдите в их условиях, кому принадлежит результат и разрешено ли коммерческое использование.
Как озвучить текст в Yandex SpeechKit без кода
SpeechKit Playground — окно в браузере: вставили текст, выбрали голос, скачали файл. Порядок по документации AI Studio:
- Откройте Yandex AI Studio, войдите в Yandex Cloud через Яндекс ID или зарегистрируйтесь и примите условия.
- Подключите платёжный аккаунт Yandex Cloud в статусе ACTIVE или TRIAL_ACTIVE. Новым пользователям из России, привязавшим карту при создании аккаунта, начисляют стартовый грант не менее 4 000 ₽ — один раз на человека.
- Выберите каталог с ролями ai.playground.user и ai.datasets.editor или выше — у владельца нового облака прав хватает.
- На панели слева разверните раздел AI Speech и откройте «Синтез речи».
- Вставьте текст длиной до 5 000 знаков.
- Справа задайте язык, голос, амплуа, скорость от 0,1 до 3,0 (1,0 — обычный темп), высоту голоса и формат.
- Нажмите «Синтезировать и воспроизвести», прослушайте результат и скачайте файл кнопкой загрузки.
Для ролика берите MP3 — SpeechKit отдаёт его наравне с OggOpus и LPCM, и его понимает любой видеоредактор. Сценарий длиннее 5 000 знаков режьте по смысловым кускам.
Какие голоса выбрать: женский, мужской, с эмоциями
В SpeechKit для русского языка 18 голосов: 11 женских и 7 мужских. У большинства несколько амплуа, у filipp и madi_ru амплуа не указаны. Детского голоса нет: высоту тона в Playground поднять можно, но это останется взрослый голос.
| Голос | Пол | Амплуа |
|---|---|---|
| marina | Ж | нейтральная, шёпот, дружелюбная |
| dasha | Ж | нейтральная, радостная, дружелюбная |
| jane | Ж | нейтральная, радостная, раздражённая |
| julia | Ж | нейтральная, строгая |
| lera | Ж | нейтральная, дружелюбная |
| masha | Ж | радостная, строгая, дружелюбная |
| omazh | Ж | нейтральная, раздражённая |
| saule_ru | Ж | нейтральная, строгая, шёпот |
| zamira_ru | Ж | нейтральная, строгая, дружелюбная |
| zhanar_ru | Ж | нейтральная, строгая, дружелюбная |
| yulduz_ru | Ж | нейтральная, строгая, дружелюбная, шёпот |
| kirill | М | нейтральный, строгий, радостный |
| alexander | М | нейтральный, радостный |
| anton | М | нейтральный, радостный |
| ermil | М | нейтральный, радостный |
| zahar | М | нейтральный, радостный |
| filipp | М | не указаны |
| madi_ru | М | не указаны |
Список сверен по странице голосов SpeechKit 19.09.2026 — перед большим проектом загляните туда ещё раз. Как выбирать под задачу:
- Новости, инструкции, разборы — нейтральное или строгое амплуа: kirill, julia.
- Развлекательный ролик — радостное или дружелюбное: dasha, masha, alexander. Не влезает в хронометраж — поднимите скорость до 1,1–1,2.
- Атмосферный текст — шёпот у marina или yulduz_ru, но только на коротком отрезке.
- Диалог разными голосами — каждую реплику синтезируйте отдельным файлом и склейте на монтаже.
Для канала правило одно: один голос на рубрику, чтобы формат узнавали с первых секунд.
Сколько стоит озвучка текста: считаем минуту ролика
По странице цен SpeechKit на 19.09.2026 (с НДС): API v1 — 1 342 ₽ за миллион знаков, API v3 — 0,1626 ₽ за единицу тарификации. Единица — каждые 250 знаков запроса: до 250 знаков — одна, от 250 до 500 — две. Пробелы и служебные символы считаются.
| Объём текста | Единиц тарификации | Стоимость в API v3, ₽ |
|---|---|---|
| 200 знаков — подпись к ролику | 1 | 0,16 |
| 260 знаков — чуть длиннее единицы | 2 | 0,33 |
| 1 000 знаков | 4 | 0,65 |
| 5 000 знаков — предел Playground за раз | 20 | 3,25 |
| 100 000 знаков | 400 | 65,04 |
| 1 000 000 знаков | 4 000 | 650,40 |
Минута речи при обычном темпе — порядка тысячи знаков с пробелами, но точную длину покажет только готовый файл. Даже вдвое более длинный минутный сценарий обойдётся в 1,30 ₽. Стартового гранта в 4 000 ₽ хватит примерно на 24,6 тысячи единиц — до 6 млн знаков, если запросы кратны 250.
Вывод: для канала цена синтеза почти ничего не значит, выбирайте сервис по голосу и доступности. И не дробите текст через API на мелкие запросы — фраза на 30 знаков стоит столько же, сколько на 249. Дорого обходится только свой голос, о нём ниже.
Можно ли озвучить текст бесплатно
Бесплатный синтез речи есть в каждом телефоне, но он читает текст вслух, а файла не даёт. Для ролика нужен файл, поэтому бесплатный путь один — SpeechKit за счёт стартового гранта. Голоса телефона годятся, чтобы прослушать текст и поймать корявые фразы.
На телефоне
Android. По справке Google: «Настройки» → «Специальные возможности» → «Синтез речи» — там выбирают синтезатор, язык, скорость и тон. У части производителей путь другой, ищите поиском по настройкам. Вслух выделенное читает функция «Озвучивание при нажатии» или Яндекс Браузер — пункт «Алиса, прочитай».
iPhone. «Настройки» → «Универсальный доступ» → «Устный контент». «Проговаривание» читает выделенное по кнопке «Произнести», «Экран вслух» — весь экран после жеста двумя пальцами вниз от верхнего края. Улучшенные голоса весят от 100 МБ.
На компьютере
Яндекс Браузер. Выделите текст, правая кнопка → «Озвучить»; страницу целиком — меню → «Озвучить страницу» или «Алиса, прочитай страницу». По справке браузера на компьютере это работает только в Windows, а страница целиком — только в режиме чтения.
SpeechKit Playground. Синтез со скачиванием файла, как в разделе выше. Платный, на старте оплачивается грантом.
Записать экран с системным голосом технически можно, но можно ли ставить такие голоса в коммерческий ролик, производители в настройках не пишут — для рекламы берите сервис с договором. SaluteSpeech Freemium здесь уже не помощник: физлицам его не продлевают с 15.07.2026.
Можно ли озвучить текст голосом Алисы
Прочитать — да, скачать — нет. Голосом Алисы читает Яндекс Браузер, но сохранить озвучку в файл его справка не предлагает, а в списке голосов SpeechKit голоса «Алиса» на 19.09.2026 нет. К сайтам, обещающим «голос Алисы со скачиванием», относитесь осторожно: в официальных продуктах Яндекса такой возможности мы не нашли.
Синтез речи в телефоне — это прослушка?
Нет. Синтез превращает текст в звук, микрофон ему не нужен. Путаница идёт от приложения «Распознавание и синтез речи от Google»: распознавание — голосовой ввод — слушает микрофон, когда вы диктуете. Если беспокоит микрофон, проверяйте это разрешение у приложений, а не отключайте синтез. Как закрыть разрешения для MAX — в статье разрешения MAX: камера, микрофон, контакты.
Как сделать, чтобы нейросеть не ошибалась в ударениях и цифрах
Синтез ошибается предсказуемо: в фамилиях, названиях городов, омографах вроде «замок» и в цифрах, где от падежа зависит окончание. Лечится это разметкой и подготовкой текста.
Разметка TTS — это служебные знаки в тексте, которые подсказывают синтезу ударение, паузу или логическое выделение. По документации SpeechKit её понимают API v3 и API v1 для русского текста:
| Что нужно | Как написать | Пример |
|---|---|---|
| Ударение | Знак + перед ударной гласной | Дверь заперта на зам+ок |
| Пауза точной длины | sil<[мс]>, до 7 000 мс | Итак. sil<[500]> Главное |
| Пауза по смыслу | <[tiny]>, <[small]>, <[medium]>, <[large]>, <[huge]> | Первое; <[medium]> второе |
| Логическое ударение | **слово** или <[accented]> | Это **бесплатно** |
| Точное произношение | Фонемы в [[ ]] через пробел | Для имён и заимствований |
Знаки разметки входят в тарифицируемые символы. В Playground проверьте разметку на коротком фрагменте, прежде чем размечать весь сценарий. Пример закадрового текста, который можно скопировать и переделать:
Как понять, что канал растёт? sil<[400]> Смотрите не на подписчиков, а на охват поста. <[small]> Если охват падает три недели подряд, меняйте формат, а не время публикации. sil<[300]> Подписывайтесь, в следующем ролике — **пять** форматов, которые читают до конца.
Подготовка текста важнее разметки — пишите для уха, а не для глаза:
- Числа, время и диапазоны — словами: «до пяти тысяч знаков», «с десяти до шести», а не «до 5 000» и «10:00–18:00».
- Сокращения раскрывайте: «ул.» и «т. к.» синтез прочитает как получится.
- Латиницу пишите так, как её произносят: «Яндекс», «эм-пэ-три».
- Скобки, ссылки и эмодзи убирайте, фразы держите до 15–20 слов: к концу длинного предложения слушатель теряет нить.
Черновик сценария можно попросить у нейросети, но вычитывать его вам — где текстовые модели врут, разобрано в статье нейросеть для текста.
Где что делается: встроенной озвучки в MAX нет, голос готовят в сервисе синтеза и приносят в канал уже внутри ролика.
Как наложить голос на видео и выложить ролик в канал MAX
Встроенной озвучки текста в MAX нет — ни в справке, ни в коде веб-версии такой функции мы не нашли. Поэтому голос готовят снаружи, а в канал приходит уже смонтированный ролик. Порядок, при котором одна ошибка не ломает весь ролик:
- Напишите сценарий для слуха и отметьте, какой кусок текста к какому кадру относится.
- Озвучьте его кусками — сцена на файл, чтобы ошибку в одной фразе исправить одним синтезом.
- Скачайте файлы в MP3 и прослушайте в наушниках: так слышны ошибки ударений.
- Соберите видеоряд: снимите на телефон или сгенерируйте — что годится из нейросетей, в обзоре нейросети для видео.
- В видеоредакторе положите озвучку на аудиодорожку и подгоняйте кадры под голос, а не наоборот. Монтаж на телефоне — в статье короткие видео для канала.
- Добавьте субтитры — текст уже есть, а смотрят не все со звуком. Музыку под голосом приглушите.
- Экспортируйте в MP4. Вложение в MAX может весить до 4 ГБ, но тяжёлый файл дольше грузится — как ужать ролик, в статье как сжать видео для MAX.
- Опубликуйте видео в канале как обычный пост — по шагам в инструкции как сделать пост в канале MAX.
Можно выложить и просто аудио. MP3 уходит через скрепку как файл: в коде веб-версии MAX форматы MP3, WAV, AAC, OGG и FLAC помечены как музыкальные, получатель видит карточку файла — подробнее в статье как отправить файл в MAX. Голосовым сообщением синтез не отправить: справка MAX описывает только запись голосового кнопкой микрофона — о ней в статье голосовые в MAX.
Можно ли озвучить текст своим голосом
Технически да, но в России это пока инструмент компаний. У Яндекса клонирование называется Brand Voice. Вариант Lite по странице цен на 19.09.2026 требует от 30 минут размеченных записей и стоит 9 150 ₽ за создание плюс 101 666 ₽ в месяц за размещение первого голоса (первые семь дней бесплатно). Premium — по запросу.
Сто тысяч рублей в месяц окупаются у колл-центра, не у канала на несколько тысяч подписчиков. Audiogram от MWS AI делает голос на заказ с ценой по заявке, а ElevenLabs в своей справке указывает Россию среди стран, откуда доступ ограничен.
Боты «клонирование голоса бесплатно» просят загрузить несколько минут вашей речи. Подумайте, кому отдаёте образец: голосовые подделки — инструмент мошенников. Если условия не говорят, где хранятся записи и кто ими пользуется, не загружайте.
Самый дешёвый способ звучать своим голосом — записать себя: хватит телефона и тихой комнаты. Личный голос берите для историй и ответов подписчикам, синтез — для рутины: инструкций, дайджестов, аудиоверсий постов.
Права на голос и маркировка: что нужно знать автору канала
Голос диктора из сервиса вы используете по договору с сервисом, проблемы начинаются с чужого голоса. Отдельной статьи о голосе в Гражданском кодексе пока нет. Изображение охраняет статья 152.1, а законопроект № 718834-8 о новой статье 152.3 — «охрана голоса гражданина», в том числе синтезированного, — внесён в Госдуму 16 сентября 2024 года и, по карточке в системе законопроектов, на 19.09.2026 даже не прошёл первое чтение.
Но «статьи нет» не значит «можно»:
- Реклама. Ролик, где синтезированный голос известного человека «рекомендует» ваш товар, рискует попасть под пункт 10 части 3 статьи 5 закона «О рекламе»: недостоверной признаётся реклама с не соответствующими действительности сведениями о рекомендациях или одобрении физических лиц.
- Выборы. Федеральный закон от 02.05.2026 № 130-ФЗ запрещает использовать в агитационных материалах созданные с помощью информационных технологий изображения и голоса людей. Исключение — сами кандидаты и совершеннолетние граждане, давшие письменное согласие.
- Правила MAX. Справка разрешает чужие материалы только с согласия правообладателя; при подтверждённом нарушении публикацию удаляют, канал могут заблокировать.
Озвученная чужая статья остаётся чужой статьёй — граница между цитатой и заимствованием разобрана в материале можно ли брать чужие посты в канал.
Нужно ли помечать озвучку нейросетью. Обязательной пометки для авторов сейчас нет. Федеральный закон от 26.07.2026 № 243-ФЗ об ИИ в основном вступил в силу 1 сентября 2026 года, а его статья 9 о маркировке заработает 1 марта 2027 года: предупреждение о применении ИИ на аудио- и видеоматериале — право автора, а дать такую техническую возможность обязаны площадки с суточной аудиторией больше 500 тысяч человек. Строка «Озвучено синтезом речи» в подписи ничего не стоит и снимает вопрос у внимательного подписчика.
Рекламный ролик с синтезом маркируется как любой рекламный пост, с erid — подробно в статье маркировка рекламы в MAX.
Частые ошибки
- Не прослушать ролик целиком. Одно чужое ударение в фамилии — и комментарии обсуждают ошибку, а не тему.
- Отдать синтезу текст поста как есть. Скобки, «ул.», «10:00–18:00» и эмодзи на слух превращаются в мусор.
- Один файл на весь ролик. Исправление одной фразы превращается в пересборку всего монтажа.
- Считать SaluteSpeech бесплатным для частных лиц. С 15.07.2026 Freemium физлицам не продлевается, а новые пакеты не продаются.
- Верить «голосу Алисы со скачиванием». В официальном списке голосов SpeechKit Алисы нет.
- Клонировать голос знаменитости для рекламы. Риск недостоверной рекламы по закону «О рекламе», даже без отдельной статьи о голосе в ГК.
- Глушить голос музыкой. Речь должна быть заметно громче фона, иначе в динамике телефона слова теряются.
Чек-лист
- Сценарий написан для слуха: короткие фразы, числа и сокращения словами, без скобок и эмодзи.
- Сложные слова размечены: + перед ударной гласной, паузы через sil и логические ударения.
- Голос и амплуа выбраны под тон канала и одинаковы во всех роликах рубрики.
- Каждый смысловой кусок озвучен отдельным файлом MP3.
- Озвучка прослушана целиком, в наушниках и через динамик телефона.
- Голос громче музыки, в ролике есть субтитры.
- Нет чужих голосов и «голосов знаменитостей», у рекламного ролика есть erid.
- В подписи стоит строка «Озвучено синтезом речи» — по желанию, но честно.
Синтез речи снимает с автора студию и дубли, но не сценарий: скучный текст диктор из нейросети просто прочитает без запинок.
Остался вопрос по теме статьи? Напишите его в предложку блога — отвечаю лично: задать вопрос в MAX. Частые вопросы разбираю отдельными статьями и присылаю ссылку тому, кто спросил.
Частые вопросы
Озвучка текста — что это и как сделать?
Озвучка текста — это синтез речи: нейросеть читает текст выбранным голосом и отдаёт аудиофайл. Tapbox проверил 19.09.2026: в Yandex SpeechKit 18 русских голосов, 1 000 знаков стоят 0,65 ₽, а SaluteSpeech с 15.07.2026 не продаёт пакеты физлицам и новым клиентам.
Какая нейросеть для озвучки текста работает на русском бесплатно?
Вслух текст бесплатно читают встроенный синтез речи Android, «Устный контент» на iPhone и Яндекс Браузер, но файла они не дают. Файл для ролика можно получить в Yandex SpeechKit за счёт стартового гранта Yandex Cloud — не менее 4 000 ₽ новым пользователям с привязанной картой. Бесплатный Freemium у SaluteSpeech физлицам с 15.07.2026 не продлевается.
Можно ли озвучить текст голосом Алисы и скачать?
Прочитать текст голосом Алисы умеет Яндекс Браузер: на компьютере с Windows — пункт «Озвучить», на Android — «Алиса, прочитай». Сохранить эту озвучку в файл справка браузера не предлагает, а голоса «Алиса» в списке Yandex SpeechKit на 19.09.2026 нет.
Можно ли озвучить текст своим голосом?
Да, но дорого: для Yandex SpeechKit Brand Voice Lite нужно от 30 минут записей, создание голоса стоит 9 150 ₽, размещение — 101 666 ₽ в месяц. ElevenLabs доступ из России ограничивает. Автору канала дешевле записать себя на телефон, а синтез оставить для рутинных роликов.
Синтез речи в телефоне — это прослушка?
Нет. Синтез речи превращает текст в звук и микрофоном не пользуется. Микрофон нужен распознаванию речи, то есть голосовому вводу, когда вы диктуете. Если беспокоит прослушка, проверьте разрешение «Микрофон» у приложений в настройках телефона.
Как наложить голос на видео для канала?
Озвучьте сценарий кусками в сервисе синтеза и скачайте MP3, положите файлы на аудиодорожку в видеоредакторе, подгоните кадры под голос, добавьте субтитры и экспортируйте в MP4. В канал MAX ролик публикуется как обычный пост с видео, вложение может весить до 4 ГБ.
Нужно ли помечать, что видео озвучено нейросетью?
Обязательной пометки для авторов сейчас нет. Статья 9 закона об ИИ № 243-ФЗ заработает 1 марта 2027 года и даёт автору право поставить предупреждение о применении ИИ на аудио- и видеоматериал. Рекламный ролик с синтезом маркируется как любая реклама, с erid.
Как сделать, чтобы нейросеть правильно ставила ударения?
В Yandex SpeechKit поставьте знак плюс перед ударной гласной: «зам+ок». Паузу задают служебной меткой sil с длительностью в миллисекундах, логическое ударение — двумя звёздочками с каждой стороны слова. Числа, время и сокращения лучше сразу написать словами.
Читайте дальше
-
 Расшифровка аудио в текст: 8 сервисов и как сделать из эфира посты
Где бесплатно перевести аудио и видео в текст, сколько стоит час записи, как расшифровать ролик по ссылке и превратить…
-
 Нейросети для бизнеса: 12 задач, которые снимают с команды
12 задач для маленькой команды: ответы, КП, встречи, отзывы, описания, скрипты, документы, отчёты, вакансии, перевод…
-
 Нейросети для картинок к постам: сервисы и готовые промпты
Обложка поста — не арт и не ролик. Kandinsky и Шедеврум из России, промпты без кривой кириллицы, права на картинку…