RAG простыми словами: как ИИ отвечает по документам компании
Как устроен RAG: поиск фрагментов в документах, передача контекста языковой модели, ответ со ссылками, обновление базы и контроль ошибок.

В этой статье
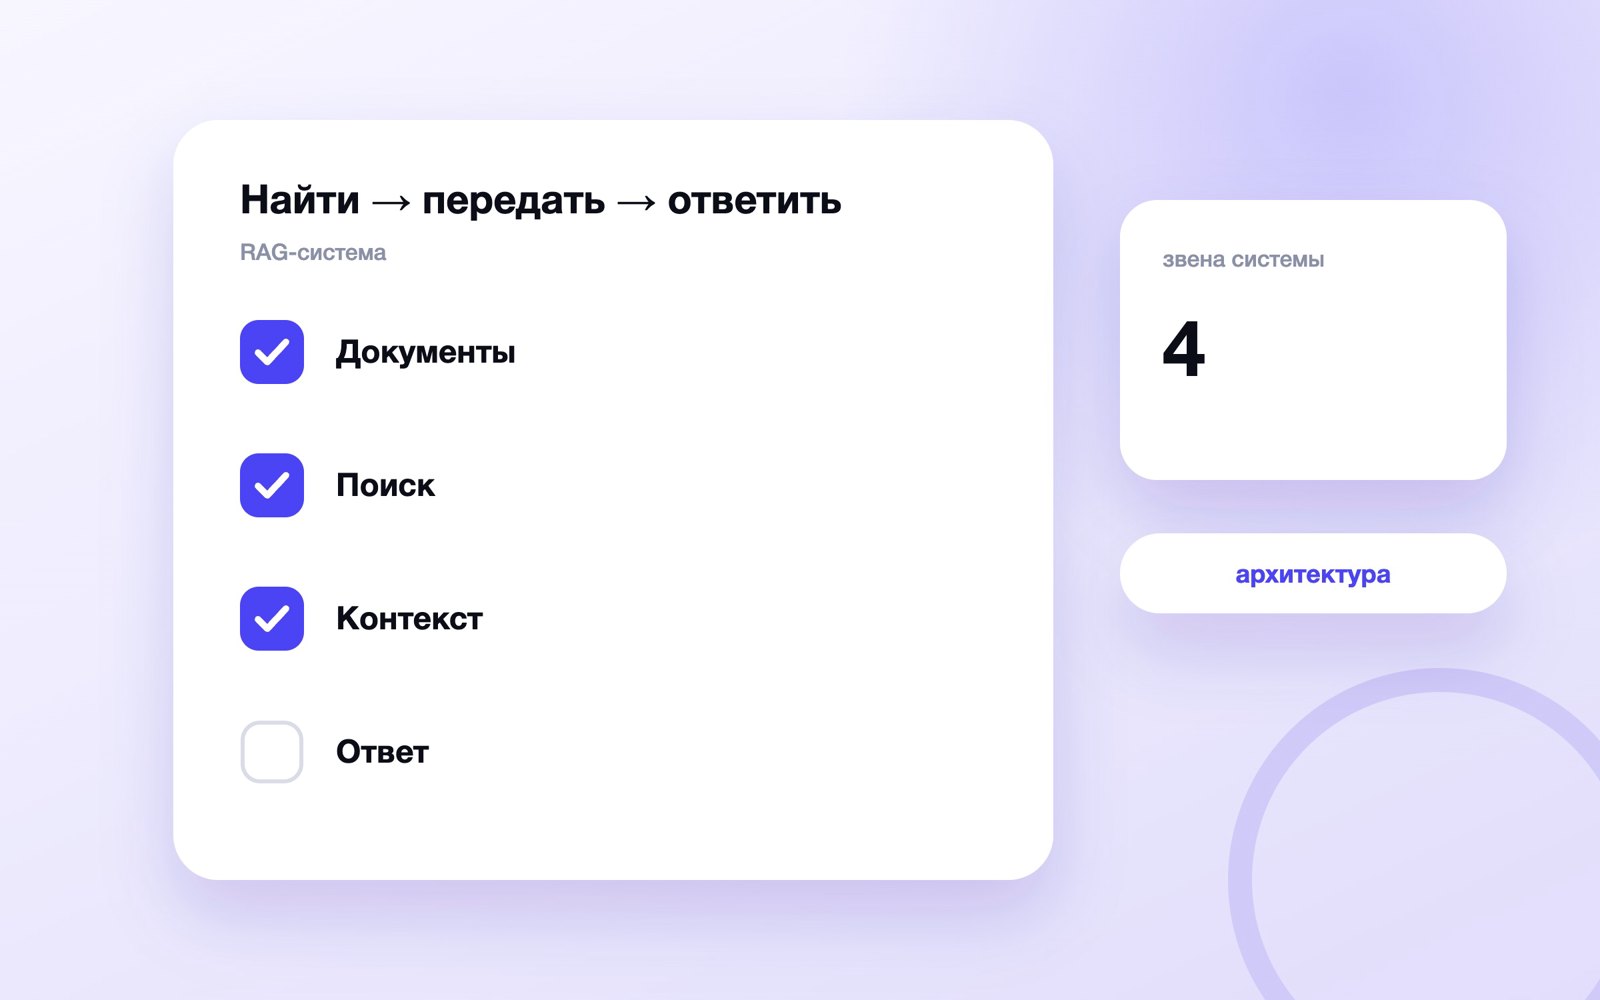
Коротко. RAG — схема, в которой система сначала находит подходящие фрагменты корпоративных документов, затем передаёт их языковой модели и просит сформировать ответ по найденному контексту. Качество зависит от документов, разбиения, поиска и правил ответа. Ссылки на источники и честный отказ обязательны: RAG снижает риск выдумки, но не устраняет его. Базовые возможности моделей разобраны в статье про генеративный ИИ.
Аббревиатура означает retrieval-augmented generation — генерацию, дополненную поиском. Вместо попытки хранить все правила в параметрах модели система подставляет актуальные документы в каждый запрос. Это удобно для инструкций, базы знаний, каталога и внутренних регламентов. Когда прототип становится рабочей системой, нужно отдельно выбрать векторную базу данных, настроить индексы, фильтры, резервирование и контроль качества выдачи.
Как работает RAG
- Документы очищают и делят на смысловые фрагменты.
- Фрагменты снабжают метаданными и индексируют.
- Вопрос пользователя преобразуют в поисковый запрос.
- Поиск возвращает несколько подходящих частей.
- Модель получает вопрос, контекст и правило ответа.
- Система показывает ответ, источники и уровень уверенности.
| Звено | Результат | Типичная ошибка |
|---|---|---|
| Документы | Актуальные знания | Старые версии |
| Чанки | Смысловые фрагменты | Потерян контекст |
| Поиск | Кандидаты | Не тот раздел |
| Модель | Связный ответ | Добавлен вымысел |
| Ссылки | Проверяемость | Источник не подтверждает тезис |
Зачем делить документы на чанки: порядок проверки
Целый файл часто не помещается в контекст и содержит много шума. Слишком короткий кусок теряет заголовок, условия и исключения. Поэтому границы проводят по разделам, абзацам и смыслу, сохраняя название документа, главу, дату и права доступа.
Перекрытие соседних фрагментов помогает не разорвать мысль, но создаёт дубли. Размер проверяют на реальных вопросах. Для таблиц, списков и договоров могут потребоваться отдельные правила обработки.
Как устроен поиск
Полнотекстовый поиск хорошо находит точные названия и номера. Семантический сопоставляет близкий смысл с помощью векторного представления. Гибридный объединяет подходы, а фильтры ограничивают продукт, регион, дату, язык и доступ. Практическая настройка индекса, эмбеддингов, гибридного ранжирования и метрик отдельно разобрана в руководстве про семантический поиск. Чтобы понять, почему семантически близкие фрагменты оказываются рядом, изучите эмбеддинги и проверьте их качество на собственных парах запросов и документов.
| Способ | Сильная сторона | Пример |
|---|---|---|
| Ключевые слова | Точные термины | Номер тарифа |
| Семантика | Перефразирование | Как вернуть заказ |
| Гибрид | Баланс | Большая база знаний |
| Фильтры | Контекст и доступ | Только действующие правила |
До выбора технологии соберите контрольные вопросы и правильные фрагменты. Иначе команда оптимизирует красивую метрику поиска, не зная, находит ли он нужные правила.
Чем RAG отличается от обучения модели: порядок проверки
Дообучение меняет поведение или веса модели, RAG подаёт знания во время запроса. Документ в RAG можно заменить и переиндексировать без нового обучения всей модели. Дообучение полезнее для устойчивого формата и поведения, но не является удобным хранилищем ежедневно меняющихся цен. Если нужно закрепить поведение, стиль или формат на собственных примерах, сначала оцените дообучение нейросети и сравните его с промптом и RAG по затратам и обновляемости.
| Задача | RAG | Дообучение |
|---|---|---|
| Свежие документы | Подходит | Требует нового цикла |
| Ссылки на источник | Естественная часть | Само по себе не даёт |
| Формат ответа | Инструкция и примеры | Можно закрепить |
| Точные правила | Нужна проверка | Тоже не гарантирует |
Какие документы подключать
Начните с материалов, у которых есть владелец, дата действия и понятная аудитория: инструкции, регламенты, справка продукта, карточки и утверждённые шаблоны. Не смешивайте черновики и действующие правила. Удаляйте дубли и храните связь с оригиналом.
Для каждого источника нужны метаданные: версия, раздел, дата обновления, продукт, язык и права. Если сотрудник не должен видеть документ напрямую, RAG не должен пересказывать его через чат.
Как система формирует ответ
Модели передают найденные фрагменты и инструкцию: отвечать только по контексту, указывать источники, сообщать о нехватке данных. Затем приложение проверяет формат, ссылки и доступ. Важные числа можно извлекать отдельным кодом, а не доверять свободной генерации.
Надёжное правило. Если найденные фрагменты не подтверждают ответ, система должна задать уточнение, предложить документы или честно отказаться, а не заполнять пробел общими знаниями.
Где RAG полезен бизнесу
| Сценарий | Источники | Контроль |
|---|---|---|
| Помощник поддержки | Справка и регламенты | Эскалация оператору |
| Поиск сотрудника | Политики и инструкции | Права доступа |
| Каталог | Карточки товаров | Цена из базы |
| Продажи | Материалы продукта | Запрет вымышленных условий |
| Юридический поиск | Утверждённые документы | Проверка специалистом |
RAG может стать инструментом ИИ-агента для бизнеса, но агент добавляет действия и состояние. Простому ответчику по базе не всегда нужны агентные возможности.
Почему RAG ошибается
Ошибка бывает до генерации: неверный документ, плохое разбиение, слабый запрос, неподходящий фильтр или недостаточное число кандидатов. Затем модель может пропустить условие или объединить несовместимые фрагменты. Отдельно проверяйте поиск и ответ.
| Симптом | Причина | Исправление |
|---|---|---|
| Нет ответа | Термин не найден | Гибридный поиск |
| Старое правило | Нет версии | Фильтр по дате |
| Ответ без условия | Чанк слишком мал | Расширить контекст |
| Уверенная выдумка | Нет правила отказа | Порог и проверка цитат |
Как оценивать качество
Соберите реальные вопросы, правильные источники и ожидаемые элементы ответа. Измеряйте, попал ли нужный фрагмент в первые результаты, подтверждает ли источник тезис, нет ли лишних утверждений и правильно ли система отказывается.
Добавьте задержку, стоимость, жалобы и долю передачи человеку. Средняя оценка скрывает опасные провалы, поэтому отдельно держите вопросы о деньгах, доступе, безопасности и обязательствах.
Как запустить пилот
- Выберите одну базу и одну группу пользователей.
- Назначьте владельцев документов.
- Очистите версии и права.
- Соберите контрольные вопросы.
- Настройте разбиение, поиск и ссылки.
- Добавьте отказ и передачу человеку.
- Протестируйте до подключения действий.
- Ведите журнал ошибок и обновлений.
Когда использовать обычный поиск
Если пользователю достаточно списка документов, генеративный слой может быть лишним. Обычный поиск быстрее показывает оригинал и не пересказывает условие. Для точной цены, статуса заказа или баланса нужен запрос к структурированной системе, а не поиск по текстовым фрагментам.
Добавляйте RAG, когда человеку приходится читать несколько частей и собирать объяснение. Даже тогда оставьте возможность открыть исходную выдачу. Пользователь должен отличать текст документа от интерпретации модели.
Как выбирать число найденных фрагментов
Один результат может пропустить исключение, десятки результатов создают шум и расходуют контекст. Подберите число на контрольном наборе и учитывайте разнообразие: пять почти одинаковых кусков хуже трёх дополняющих. Повторный ранжировщик может поднять наиболее подходящие кандидаты.
Для сложного вопроса полезно сначала уточнить продукт, регион или дату, затем искать. Уточнение часто надёжнее расширения выдачи. Логи таких диалогов показывают, каких метаданных не хватает базе.
Как показывать источники
Ссылка должна вести не просто на файл, а по возможности на раздел или страницу. Рядом показывайте название, версию и дату действия. Цитируемый фрагмент должен действительно подтверждать предложение ответа; совпадение по теме недостаточно.
Если ответ объединяет несколько документов, сопоставьте тезисы и источники. При противоречии не выбирайте удобный вариант молча: покажите конфликт и направьте владельцу знаний.
Как управлять стоимостью и задержкой
Измеряйте время поиска, подготовки контекста и генерации отдельно. Кешируйте только там, где ответ не зависит от прав, свежести и персонального состояния. Ограничьте длину фрагментов и не передавайте повторяющийся текст.
Экономить можно маршрутизацией: точные запросы отправлять к базе, навигационные — в поиск, сложные объяснения — в RAG. Но ошибку выбора пути тоже включают в тесты и наблюдение.
Как вести обратную связь
Кнопка «не помогло» без причины мало полезна. Предложите выбрать: не найден документ, ответ неверен, не хватает условия, источник устарел или нет доступа. Свяжите сигнал с запросом, найденными фрагментами и версией системы.
Не превращайте пользовательскую оценку в единственную метрику: человек может одобрить удобный, но неверный ответ. Выборочно проверяйте факты экспертами и добавляйте подтверждённые ошибки в контрольный набор. Полученный ответ всё равно должен пройти фактчекинг текста.
Чек-лист RAG-системы
Пример: помощник по внутренним инструкциям
Сотрудник спрашивает, как согласовать возврат дороже установленного лимита. Поиск должен найти не общий документ о возвратах, а раздел с порогом, ролью согласующего и исключениями. Ответ перечисляет шаги и даёт ссылки на конкретные разделы. Если дата документа истекла, он не участвует в выдаче.
Контрольный набор включает прямой вопрос, разговорную формулировку, неверную предпосылку и случай, которого в инструкции нет. Последний особенно важен: система должна признать отсутствие правила и направить владельцу процесса, а не придумать разрешение.
Пример: ответы по каталогу
Покупатель спрашивает, подойдёт ли устройство для помещения определённой площади. Описание и руководство можно искать через RAG, но актуальную цену и остаток лучше получать точным запросом к базе. Ответ объединяет два источника, при этом каждое поле имеет владельца и время обновления. Качество ответа начинается с инструкции — используйте руководство как написать промпт.
Если характеристика отсутствует, система не выводит её из похожей модели. Она показывает найденные параметры и предлагает уточнить у специалиста. Такое разделение свободного текста и структурированных данных снижает риск красивого, но ложного ответа.
Как подготовить документы
Составьте реестр источников и уберите копии. Для каждого файла укажите владельца, область действия, дату начала и окончания, уровень доступа и канонический адрес. Сканированные страницы распознайте и выборочно сравните с оригиналом; ошибки распознавания особенно опасны в числах и отрицаниях.
| Проблема | Почему мешает | Решение |
|---|---|---|
| Несколько версий | Поиск возвращает противоречия | Один действующий оригинал |
| Нет заголовков | Теряется структура | Разметить разделы |
| Скан плохого качества | Искажены слова и числа | Распознавание и сверка |
| Смешаны права | Возможна утечка | Фильтр до извлечения |
| Нет даты | Нельзя выбрать актуальное | Обязательные метаданные |
Как составить контрольный набор
Берите реальные вопросы из поиска, поддержки и интервью. Для каждого запишите ожидаемый источник, обязательные элементы ответа и допустимый отказ. Добавьте синонимы, опечатки, короткие вопросы без контекста и запросы, которые пользователь не имеет права задавать.
Разделите набор на настройку и независимую проверку. Если постоянно исправлять систему по всем примерам и ими же измерять качество, оценка станет завышенной. Новые ошибки добавляйте в регрессионный набор, чтобы обновление не возвращало старую проблему.
Как проверять найденные фрагменты
Метрика попадания показывает, оказался ли правильный фрагмент среди первых результатов. Но этого мало: лишние документы могут отвлечь модель. Оцените порядок, полноту и противоречия. Просматривайте запрос, найденный текст и финальный ответ одной цепочкой.
| Уровень | Вопрос проверки | Сбой |
|---|---|---|
| Поиск | Найден правильный документ? | Нет нужного фрагмента |
| Контекст | Хватает условий? | Потеряно исключение |
| Ответ | Каждый тезис подтверждён? | Добавлен вымысел |
| Ссылка | Ведёт к нужному месту? | Файл не подтверждает |
| Доступ | Можно показать источник? | Утечка закрытого раздела |
Как обновлять индекс
Изменение оригинала должно запускать обработку новой версии, удаление старых фрагментов и контрольный тест. Следите за неудачными загрузками: документ может обновиться в хранилище, но остаться старым в поиске. Показывайте пользователю дату источника.
Для срочного отзыва документа нужна возможность исключить его немедленно, не ожидая полного ночного пересчёта. Храните журнал: какой файл, когда и какой версией был проиндексирован.
Безопасность и защита от инструкций в документах
Найденный текст считается данными, а не командой системе. Документ может содержать фразу, предлагающую игнорировать правила или раскрыть секрет. Разделяйте системную инструкцию и контент, ограничивайте инструменты, проверяйте выход и не позволяйте найденному фрагменту повышать права. Если команде нужна не база знаний, а рабочие чаты, созвоны и совместные пространства, сравните аналоги Slack в России по сценарию, размещению данных и администрированию. При работе с объявлениями учитывайте отдельные риски и сценарии ИИ в рекламе. Для системы, которая не только отвечает, но и выполняет действия, применяйте отдельную модель безопасности ИИ-агентов: минимальные права, подтверждения и журнал операций.
Доступ фильтруют до передачи текста модели. Маскирование ответа после генерации слишком поздно: закрытая информация уже попала в контекст. Журналы также защищают, потому что в них остаются вопросы и фрагменты документов.
- У каждого документа есть владелец и версия.
- Черновики отделены от действующих правил.
- Доступ проверяется до поиска.
- Контрольный набор включает сложные случаи.
- Поиск и генерация оцениваются отдельно.
- Ответ показывает подтверждающие источники.
- Есть честный отказ и эскалация.
- Обновление документа запускает переиндексацию.
- Чувствительные вопросы проверяет человек.
RAG — не волшебная память, а поисковая система с генеративным интерфейсом. Чем яснее документы и ответственность за них, тем надёжнее ответ.
Как проверить прототип RAG на своих документах
Соберите набор реальных вопросов с известными ответами, включая случаи, когда данных нет. Для каждого ответа сохраняйте найденные фрагменты, источник и версию документа. Система должна отказываться от уверенного вывода, если поиск не дал достаточной опоры, а не дополнять пробел общими знаниями модели.
Ошибки делите на этапы: документ не попал в индекс, нужный фрагмент потерялся при разбиении, поиск выбрал соседний текст или генерация исказила найденное. Такое разделение подсказывает конкретное исправление. Общая оценка «бот отвечает плохо» не показывает, нужно ли менять базу, поиск, инструкцию или интерфейс ссылки на источник.
Финальная проверка материала «RAG простыми словами»
| Участок | Что проверить | Что зафиксировать |
|---|---|---|
| 1. Как работает RAG | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 1; отдельно записать ограничение. |
| 2. Зачем делить документы на чанки: порядок проверки | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 2; отдельно записать ограничение. |
| 3. Как устроен поиск | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 3; отдельно записать ограничение. |
| 4. Чем RAG отличается от обучения модели: порядок проверки | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 4; отдельно записать ограничение. |
| 5. Какие документы подключать | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 5; отдельно записать ограничение. |
| 6. Как система формирует ответ | Сохранить исходные данные и проверить вывод на одном реальном примере по теме «RAG простыми словами». | Назначить владельца, срок и наблюдаемый результат для этапа 6; отдельно записать ограничение. |
Эту таблицу используют после основного разбора «RAG простыми словами», а не вместо него. Сначала команда подтверждает исходные данные, затем выполняет действие и только после этого сравнивает результат с выбранным критерием. Если условия изменились в середине проверки, такой период помечают отдельно и не объединяют с сопоставимой выборкой.
Остался вопрос по теме статьи? Напишите его в предложку блога — отвечаю лично: задать вопрос в MAX. Частые вопросы разбираю отдельными статьями и присылаю ссылку тому, кто спросил.
Частые вопросы
Что такое RAG простыми словами?
RAG — схема, в которой система сначала находит подходящие фрагменты документов, а затем передаёт их языковой модели для ответа на вопрос.
Чем RAG отличается от обучения модели?
RAG не обязан менять веса модели: знания подаются в контексте каждого запроса. Документ можно обновить без нового обучения всей модели.
Зачем делить документы на чанки?
Поиск должен вернуть небольшой фрагмент с законченным смыслом. Целый длинный файл создаёт шум, слишком короткий кусок теряет контекст.
Обязательно ли использовать векторный поиск?
Нет. Применяют полнотекстовый, семантический или гибридный поиск и фильтры. Выбор зависит от вопросов, языка, объёма и требований к точности.
Устраняет ли RAG галлюцинации?
Нет. Он даёт модели более подходящий контекст, но поиск может ошибиться, а модель — исказить фрагмент. Нужны ссылки, порог уверенности и отказ от ответа.
Какие документы подходят для RAG?
Актуальные инструкции, регламенты, база знаний, карточки товаров и договорные шаблоны с владельцем, датой действия и понятными правами доступа.
Как оценивать RAG?
Отдельно измеряют качество поиска, обоснованность ответа источниками, полноту, корректный отказ, задержку и стоимость на контрольном наборе вопросов.
Когда RAG не нужен?
Когда ответ определяется простым фильтром, точным полем базы или жёстким правилом. Обычный поиск либо код будет дешевле и предсказуемее.
Читайте дальше
-
 Клонирование голоса нейросетью: как работает и где границы
Клонирование голоса нейросетью — практическая система, в которой синтетический голос создаётся на качественных…
-
 Суммаризация текста: как сделать точное саммари нейросетью
Суммаризация текста — практическая система, в которой читатель получает краткое самостоятельное резюме, где важность…
-
 Как написать статью с помощью нейросети и не получить шаблонный текст
Статья с помощью нейросети — практическая система, в которой нейросеть ускоряет исследование, план и черновик, а…