OCR для счетов, актов и накладных: как распознавать первичку
OCR первичных документов превращает скан или фотографию в структурированные реквизиты, но сам по себе не гарантирует бухгалтерскую точность. Надёжный процесс сначала определяет тип документа, изв

В этой статье
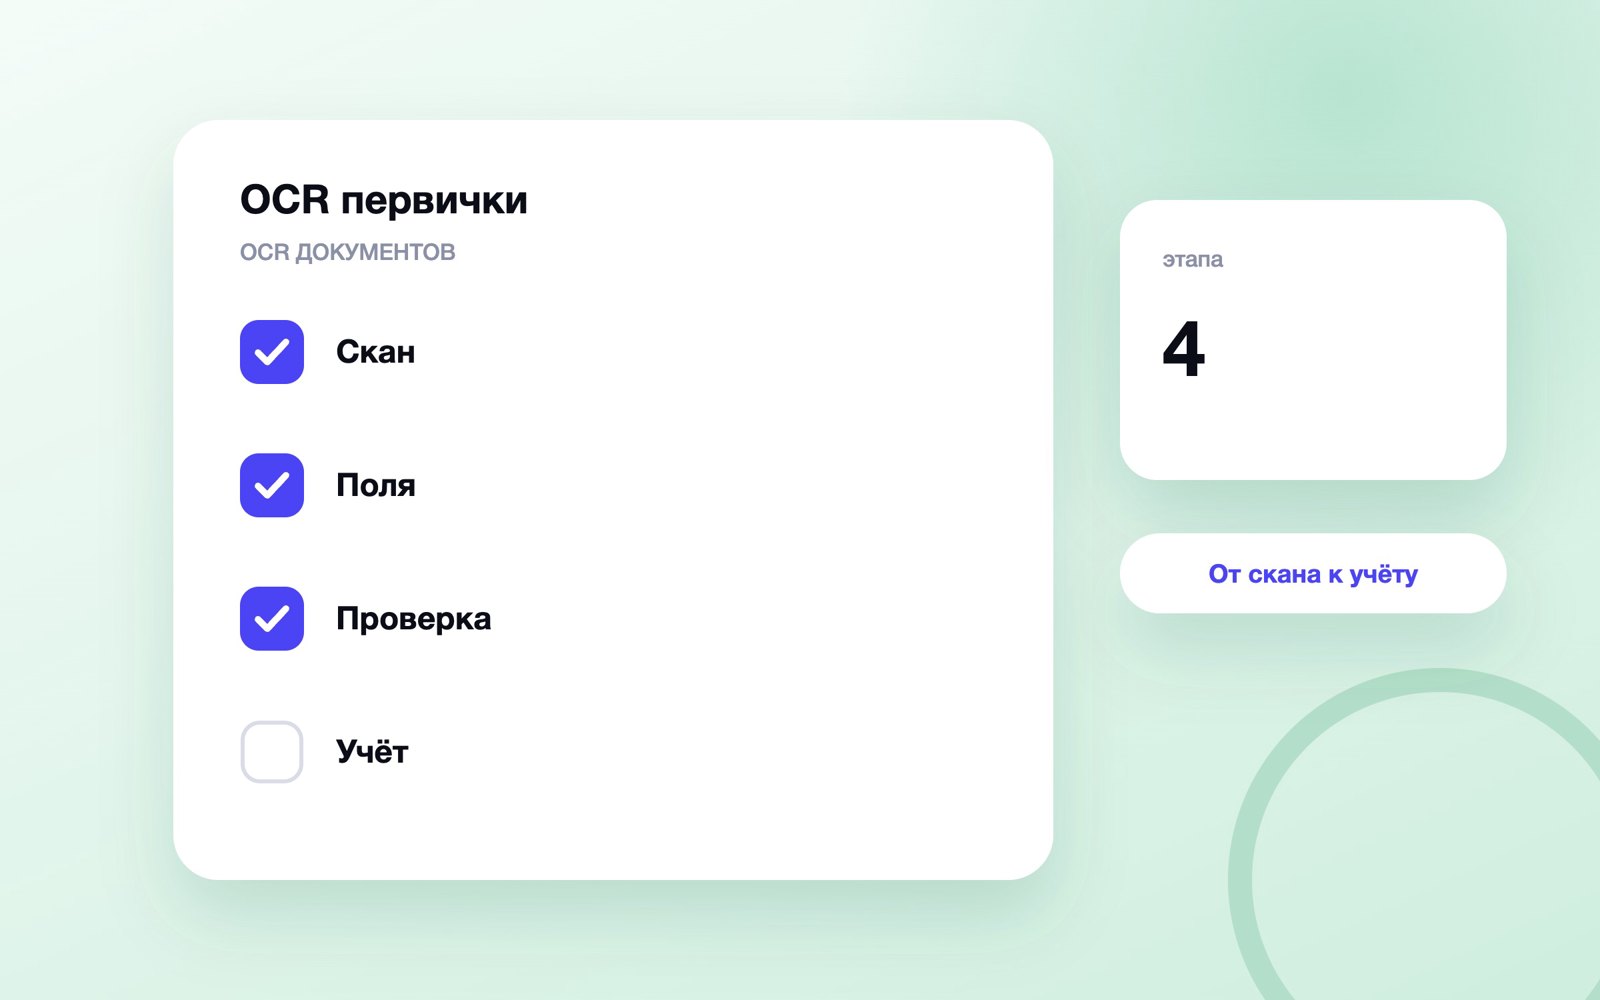
Коротко. OCR первичных документов превращает скан или фотографию в структурированные реквизиты, но сам по себе не гарантирует бухгалтерскую точность. Надёжный процесс сначала определяет тип документа, извлекает поля и строки таблицы, затем проверяет ИНН, даты, суммы и арифметику, отправляет сомнительные значения человеку и только после этого создаёт запись в учётной системе.
Распознать печатные символы проще, чем правильно понять документ. Одинаковая сумма может быть итогом, налогом или авансом; номер часто соседствует с датой; табличная строка переносится на следующую страницу. Поэтому проект OCR оценивают по корректности нужных полей и стоимости проверки, а не по красивому текстовому слою.
| Слой | Главный вопрос | Артефакт |
|---|---|---|
| Граница | Что входит в процесс | Правила и исключения |
| Проверка | Как доказать качество | Контрольная выборка |
| Эксплуатация | Что делать при ошибке | Журнал и владелец |
Определите документы и результат
Счёт, акт, накладная и счёт-фактура содержат разные обязательные реквизиты и используются на разных этапах учёта.
Что сделать. Для каждого типа перечислите поля, табличные строки, формат выгрузки и действие после успешной проверки.
Как проверить. Пользователь учётной системы должен подтвердить, что результата достаточно без повторного ручного ввода.
Типичная ошибка. Не начинайте с требования «распознать всё»: оно не задаёт измеримого результата.
Соберите репрезентативную выборку
Качество зависит от поставщика, шаблона, сканера, языка, числа страниц, печатей и рукописных пометок.
Что сделать. Возьмите документы разных контрагентов, старые и новые формы, хорошие сканы и реальные проблемные фотографии.
Как проверить. Отделите контрольную выборку и не используйте её для ручной подстройки правил.
Типичная ошибка. Не демонстрируйте точность на десяти идеально сформированных PDF одного поставщика.
Основные определения и границы вынесены в материал Автоматизация маркетинга; здесь достаточно применить их к текущему шагу.
Подготовьте изображение
Перекос, тень, низкое разрешение и сжатие ухудшают не только буквы, но и координаты таблицы.
Что сделать. Поворачивайте страницу, выравнивайте перспективу, убирайте фон, проверяйте разрешение и разделяйте многостраничный файл.
Как проверить. Сохраняйте исходник и версию после обработки, чтобы разбирать причину ошибки.
Типичная ошибка. Не повышайте контраст настолько, чтобы исчезали тонкие цифры, точки и разделители.
Определите тип и шаблон
До извлечения полей системе полезно понять вид документа и, при необходимости, семейство шаблонов поставщика.
Что сделать. Используйте заголовки, ключевые реквизиты и расположение блоков; для неизвестного типа отправляйте документ в отдельную очередь. Разделите обязательный минимум и улучшения.
Как проверить. Считайте ошибки классификации отдельно от ошибок распознавания поля.
Типичная ошибка. Не применяйте координаты одного шаблона ко всем документам с похожим названием.
Перед настройкой этого этапа полезно свериться со статьёй База знаний компании.
Извлеките реквизиты
Название организации, ИНН, номер, дата, договор, валюта и итог требуют не только OCR, но и нормализации.
Что сделать. Храните исходное значение, нормализованное значение, координаты на странице и уверенность модели.
Как проверить. Проверяющий должен открыть конкретный фрагмент изображения по одному клику.
Типичная ошибка. Не заменяйте непонятный символ наиболее вероятной цифрой без отметки сомнения.
Разберите табличную часть
Строки номенклатуры сложнее шапки: ячейки переносятся, объединяются, продолжаются на следующей странице и содержат несколько ставок. Этот слой соединяет данные и решение.
Что сделать. Восстанавливайте границы строк, связывайте описание, количество, цену, ставку и сумму; сохраняйте порядок страниц.
Как проверить. Проверяйте число строк и арифметику по каждой позиции, а не только общий итог.
Типичная ошибка. Не склеивайте две строки по близости текста, если расходятся суммы или единицы измерения.
Добавьте бизнес-валидацию
Формат ИНН, допустимая дата и равенство итогов ловят ошибки, которые OCR считает уверенными.
Что сделать. Настройте справочники контрагентов, контроль длины реквизитов, валюты, НДС и суммы позиций.
Как проверить. Разделяйте предупреждение и блокирующую ошибку, чтобы не останавливать безопасные случаи.
Типичная ошибка. Не подменяйте исходный документ данными из справочника молча: показывайте расхождение.
Если на этом шаге не хватает исходных правил, используйте материал Персональные данные в мессенджере, затем вернитесь к контрольному примеру.
Организуйте ручную проверку
Автоматизация окупается, когда человек видит только сомнительные поля и исключения, а не перечитывает весь документ.
Что сделать. Сортируйте очередь по риску и сумме, подсвечивайте фрагмент, предлагайте варианты и записывайте исправление.
Как проверить. Измеряйте время проверки, долю полностью автоматических документов и причины возврата.
Типичная ошибка. Не скрывайте низкую уверенность за зелёной кнопкой «готово». Не исправляйте историю под новую логику.
Защитите документы
Первичка содержит реквизиты, подписи, адреса и коммерческие сведения; загрузка во внешний сервис меняет контур обработки.
Что сделать. Опишите место хранения, шифрование, сроки удаления, доступ сотрудников, регион обработки и договор с поставщиком.
Как проверить. Проведите тест удаления и проверьте журнал доступа к исходникам и выгрузкам.
Типичная ошибка. Не отправляйте реальные документы в бесплатный демосервис без проверки условий. Не измеряйте только скорость первого шага.
Материал Маркетинговая аналитика для малого бизнеса помогает подготовить данные для этого этапа, но результат нужно проверить в общей цепочке.
Интегрируйте и измерьте результат
После распознавания данные должны безопасно попасть в 1С, ERP или архив без дублей и потери связи с оригиналом.
Что сделать. Передавайте внутренний ID, версию, статус проверки и ссылку на исходник; повторная загрузка не должна создавать вторую операцию.
Как проверить. Считайте точность по критическим полям, straight-through rate, время и стоимость одного принятого документа.
Типичная ошибка. Не объявляйте проект успешным по общей точности символов, если ошибки остаются в сумме или контрагенте.
Связанная задача раскрыта в статье Юнит-экономика.
Опишите контракт результата до выбора OCR
Начните не с процента распознанных символов, а с таблицы, которую должна получить учётная система. Для каждого поля укажите тип, обязательность, формат, допустимое значение, источник проверки и действие при сомнении. Номер документа может быть строкой с буквами, дата — календарным значением, а сумма — десятичным числом вместе с валютой. Если всё хранить как текст, ошибки обнаружатся уже при проведении операции.
Рядом с нормализованным значением сохраняйте исходную строку, страницу и координаты фрагмента. Проверяющий должен одним нажатием увидеть, откуда взялись ИНН, сумма или ставка НДС. Поле, которого нет в документе, отличается от поля, которое модель не смогла прочитать: это два разных статуса и два разных маршрута.
| Поле | Тип и правило | Автопроверка | При ошибке |
|---|---|---|---|
| ИНН продавца | Строка установленной длины | Формат и справочник контрагентов | Показать фрагмент оператору |
| Номер документа | Строка без потери букв и разделителей | Дубль у того же контрагента | Не создавать вторую запись |
| Дата | Дата в допустимом периоде | Не позже загрузки и не раньше договора | Запросить подтверждение |
| Итого | Сумма и валюта | Равна строкам с учётом НДС и округления | Заблокировать проведение |
| Позиция | Описание, количество, цена, ставка | Количество × цена и итог строки | Отправить строку на ручной разбор |
Разделите качество изображения и качество извлечения
Плохой результат может появиться до OCR: страница обрезана, снята под углом, пересвечена или сжата мессенджером. Сделайте автоматический входной контроль — число страниц, разрешение, поворот, размытие, контраст и наличие границ документа. Непригодный файл лучше сразу вернуть с конкретной причиной, чем получить уверенную таблицу с неверными цифрами.
Ошибки классификации считайте отдельно. Если акт принят за счёт, правильное распознавание букв не спасёт схему полей. На контрольной выборке должны быть документы разных поставщиков, версии шаблонов, фотографии с телефона, сканы, многостраничные PDF, печати, рукописные пометки и таблицы с переносом на следующую страницу.
Измеряйте точность по полям и бизнес-риску
Общая character accuracy полезна для диагностики движка, но бизнесу важнее доля документов, которые можно принять без исправлений. Считайте exact match отдельно для ИНН, номера, даты, валюты, итоговой суммы и строк. Для суммы даже одна неверная цифра означает полный провал поля, хотя почти все символы страницы распознаны правильно.
Добавьте взвешенную оценку: критическим реквизитам дайте больший вес, описанию позиции — меньший. Отдельно показывайте straight-through rate — долю документов, прошедших без ручной правки, медианное время проверки и стоимость одного принятого документа. Сравнивайте версии на неизменной закрытой выборке, иначе подстройка под знакомые примеры выдаст ложный рост.
| Показатель | Единица | Зачем нужен |
|---|---|---|
| Exact match критических полей | % полей | Показывает риск неверной проводки |
| Точность строк | % полностью верных строк | Ловит смещения колонок и переносы |
| Straight-through rate | % документов | Показывает реальную автоматизацию |
| Время проверки | минуты на документ | Считает скрытый ручной труд |
| Возвраты после импорта | случаи и причины | Находит ошибки, пропущенные первым контролем |
Постройте очередь исключений для бухгалтера
Интерфейс проверки должен показывать не весь документ, а конкретное сомнительное поле рядом с увеличенным фрагментом. Полезны исходное значение, предложение OCR, результат справочника и причина предупреждения. Горячие клавиши и переход к следующей ошибке ускоряют работу сильнее, чем ещё один процент общей точности модели.
Очередь сортируют по риску: дубли, суммы и контрагенты выше косметических расхождений. Исправление сохраняют как отдельное событие — кто, когда, что увидел и какое значение подтвердил. Его можно использовать для улучшения правил после обезличивания, но нельзя молча переписывать исходный результат: иначе аудит не объяснит происхождение данных.
Передавайте документ в учётную систему идемпотентно
У каждой загрузки должен быть стабильный ключ, например организация, тип, контрагент, номер и дата документа. Повтор того же файла обновляет черновик либо отклоняется как дубль, но не создаёт вторую операцию. Вместе с полями передавайте статус проверки, версию схемы и ссылку на защищённый оригинал.
Сначала интегрируйте тестовый контур: создавайте непроведённые документы и сверяйте их с ручным вводом. Проведение, оплату и отправку отчётности оставьте человеку до тех пор, пока критические поля не проходят согласованный порог на нескольких поставщиках и периодах. Ошибка передачи и ошибка OCR должны иметь разные коды — так понятно, что исправлять.
План пилота OCR на реальной первичке
- Выберите один тип документа и 100–300 обезличенных примеров от разных контрагентов.
- Зафиксируйте ручное время ввода, частые ошибки и стоимость исправления до автоматизации.
- Разделите примеры на настройку и закрытый контроль; контроль не используйте для подгонки правил.
- Настройте входной контроль, извлечение, бизнес-валидацию и очередь исключений.
- Создавайте результат только в тестовой базе или как непроведённый черновик.
- Сравните точность критических полей, долю автоматического прохождения, время и возвраты.
Пилот расширяют на новый тип документа только после разбора всех критических ошибок текущего набора. Если straight-through rate растёт, а возвраты после импорта не увеличиваются, автоматизация действительно снимает ручной труд. Если бухгалтер всё равно перечитывает каждую страницу, проект пока лишь перенёс ввод в другой интерфейс.
Перед расширением сохраните эталонный пакет и версию всех правил: предобработки, классификации, извлечения, справочников и выгрузки. Новый поставщик или обновлённый шаблон сначала проходит этот пакет в тестовом контуре. Так можно понять, какой слой ухудшил результат, а не менять OCR, справочник и интеграцию одновременно.
Экономику считайте по принятому документу: стоимость распознавания, хранение, время проверки, сопровождение интеграции и исправление возврата. Дешёвый вызов модели не делает процесс дешёвым, если специалист по-прежнему тратит несколько минут на поиск каждой сомнительной цифры.
Чек-лист рабочего OCR-контура
- Для каждого поля определены тип, формат, обязательность и источник проверки.
- Исходный файл и фрагмент поля доступны проверяющему без поиска вручную.
- Отсутствующее, нераспознанное и сомнительное значение имеют разные статусы.
- Контрольная выборка отделена от примеров, на которых настраивали систему.
- Критические поля оцениваются отдельно от общей точности символов.
- Повторная загрузка защищена от создания дубля.
- Реальные документы хранятся ограниченный срок с журналом доступа и удаления.
- В учётную систему до подтверждения попадает черновик, а не проведённая операция.
Рабочий результат OCR — не JSON, который выглядит заполненным, а документ, чьи критические поля можно проследить до изображения, проверить правилами и безопасно принять в учётной системе без повторного ручного ввода.
Остался вопрос по теме статьи? Напишите его в предложку блога — отвечаю лично: задать вопрос в MAX. Частые вопросы разбираю отдельными статьями и присылаю ссылку тому, кто спросил.
Частые вопросы
Чем OCR отличается от распознавания документа?
OCR получает символы, а документный процесс дополнительно определяет поля, таблицы, тип документа и проверяет бизнес-правила.
Можно ли полностью убрать ручную проверку?
Только для устойчивых шаблонов и низкорисковых операций после достаточной контрольной выборки; исключения всё равно требуют маршрута.
Какая метрика OCR важнее общей точности текста?
Точность критических полей и доля документов, прошедших процесс без исправлений при допустимом риске.
Как распознавать таблицы в накладных?
Восстанавливать строки и столбцы с учётом координат, многостраничности и проверять количество, цену, ставку и сумму.
Нужно ли хранить исходное изображение?
Да, в пределах установленного срока: оно нужно для проверки, аудита и разбора ошибки распознавания.
Как оценить окупаемость OCR?
Сравнить полную стоимость обработки документа до и после: сервис, интеграция, ручная проверка, исправления и цена ошибки.
Читайте дальше
-
 Как описать ошибку разработчику: шаблон баг-репорта и помощь ИИ
Баг-репорт описывает одну ошибку так, чтобы разработчик смог повторить её без переписки: контекст, точные шаги…
-
 Как добавить администратора в Telegram-канал и настроить права
Чтобы добавить администратора в Telegram-канал, владелец открывает управление каналом, раздел администраторов…
-
 Как создать бота в Telegram: пошаговый запуск через BotFather
BotFather создаёт учётную запись Telegram-бота и выдаёт токен. На этом бот ещё ничего не умеет: логику запускают в…