llms.txt: что это за файл, как его составить и нужен ли он сайту
Что такое llms.txt, как его составить по спецификации llmstxt.org, чем он отличается от llms-full.txt, влияет ли на Google и Яндекс — и два живых файла tapbox.ru в пример.

В этой статье
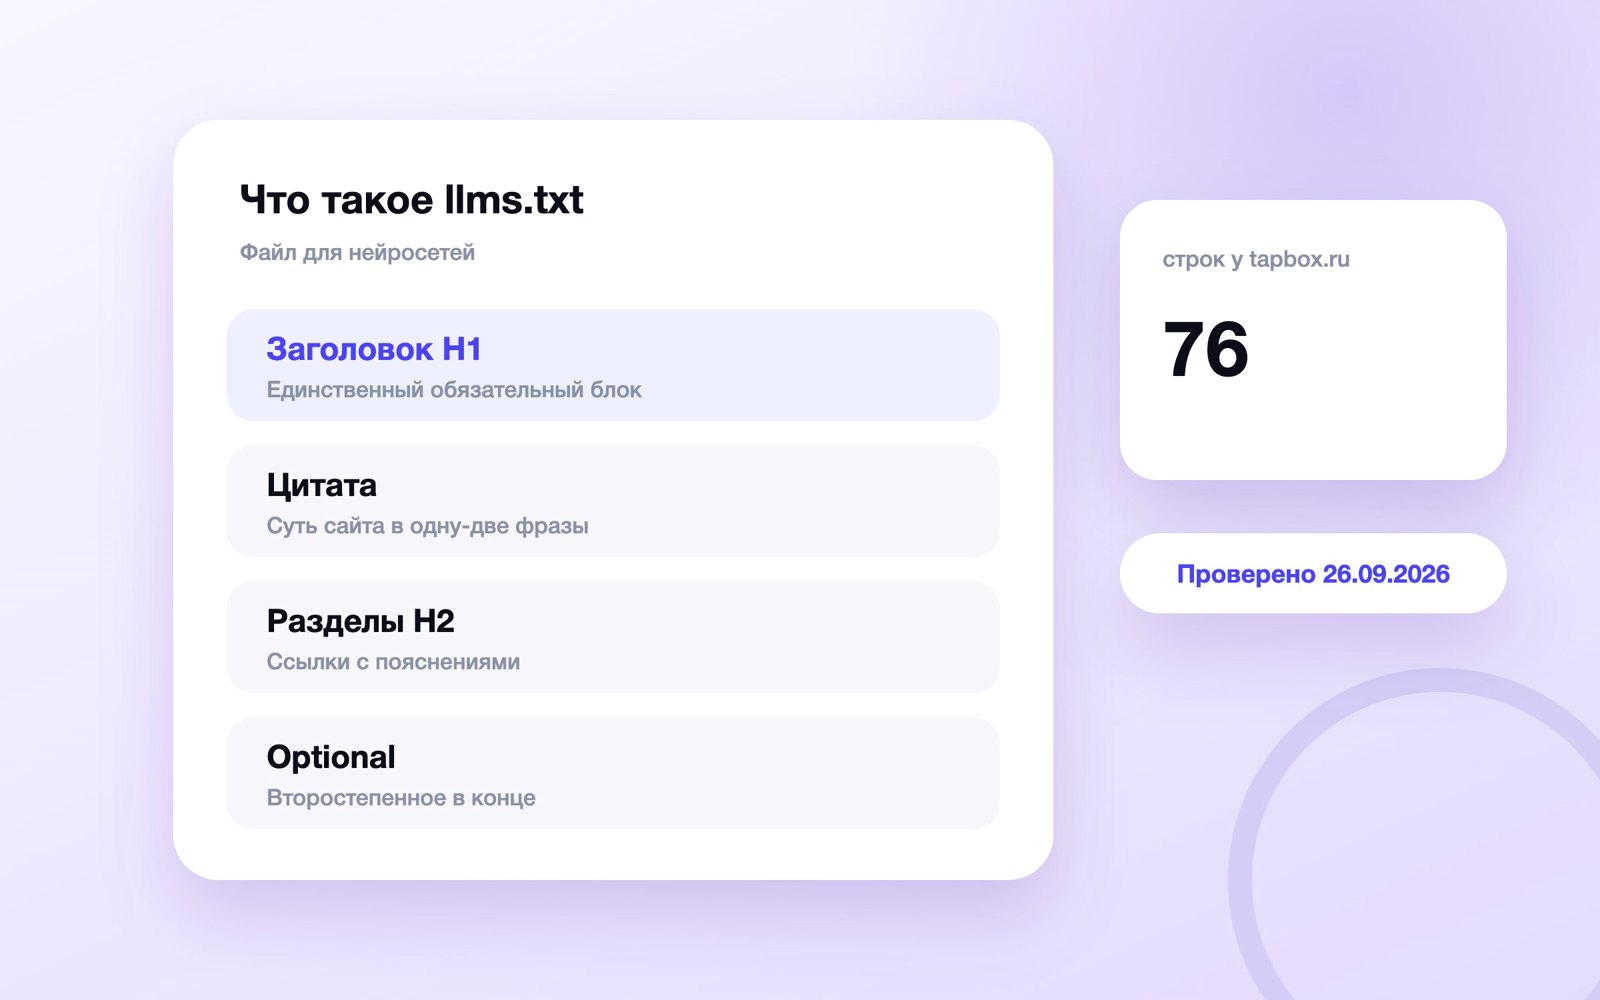
Коротко. llms.txt — текстовый файл в корне сайта, который языком Markdown описывает сайт и даёт нейросетям ссылки на главные страницы. Лежит по адресу сайт.ру/llms.txt, и по спецификации llmstxt.org обязателен в нём только заголовок H1. Поиск Google этот файл не использует — так сказано в его руководстве после правки от 15 июня 2026 года.
Формат предложил Джереми Говард из Answer.AI в сентябре 2024 года, в августе 2026-го вышла вторая версия спецификации. Файл собирается за вечер, но вокруг него много обещаний, которых поисковики не давали. Ниже — кто его читает, как составить его по шагам, чем помогут генераторы и как устроены два живых файла tapbox.ru, которые мы открыли 26 сентября 2026 года.
Что такое llms.txt простыми словами
llms.txt — это оглавление сайта для машины. Человек видит меню, баннеры и кнопки, а нейросети, которая пришла за ответом, всё это мешает: из HTML-страницы трудно вынуть чистый текст, и каждый лишний кусок тратит её окно контекста. Поэтому сайт кладёт в корень один короткий файл: кто мы, что главное и где лежат подробности.
В названии LLM — large language model, большая языковая модель, то есть нейросеть вроде ChatGPT, Claude, GigaChat или YandexGPT. Буква s — множественное число: файл для всех языковых моделей сразу. А Markdown — это разметка обычным текстом: решётка «#» делает заголовок, знак «>» — цитату, дефис — пункт списка, а запись [текст](адрес) — ссылку. Такой файл одинаково читают человек, нейросеть и простая программа.
llms.txt часто путают с robots.txt и картой сайта. Роли у них разные:
| Файл | Для кого и зачем | Что внутри |
|---|---|---|
| robots.txt | Для роботов поисковиков: куда можно заходить, куда нельзя | Правила Allow и Disallow по именам роботов |
| sitemap.xml | Для поисковиков: все страницы, которые надо проиндексировать | Полный список адресов с датами, без описаний |
| llms.txt | Для нейросетей и ИИ-агентов: как быстро понять сайт | Суть сайта, ключевые факты и отобранные ссылки с пояснениями |
| Микроразметка | Для поисковиков и нейросетей: что за объект на странице | Код Schema.org внутри каждой страницы |
robots.txt запрещает и разрешает, карта сайта перечисляет всё подряд, а llms.txt отбирает главное и объясняет его словами. Микроразметка работает на уровне отдельной страницы: какие её типы нужны сайту и блогу и что из них берут поиск и нейросети, мы разобрали в статье «Микроразметка Schema.org простыми словами».
Читают ли llms.txt нейросети и нужен ли он сайту
Короткий ответ: ни Google, ни Яндекс не заявляли, что учитывают файл, а Google прямо написал, что его не использует. Читают файл ИИ-агенты, когда им поручают разобраться с сайтом или документацией. Официальные заявления и документация на 26 сентября 2026 года — в таблице.
| Кто | Что известно на 26.09.2026 |
|---|---|
| Google Search | В руководстве по оптимизации для ИИ: Поиск такие файлы не использует, на позиции они не влияют ни в плюс, ни в минус |
| Яндекс | В справке Вебмастера о robots.txt про llms.txt ни слова. Тексты для быстрых ответов с YandexGPT собирает робот YandexAdditionalBot, доступ ему задаётся в robots.txt. Сама справка Вебмастера свой llms.txt публикует |
| OpenAI | В описании роботов GPTBot и OAI-SearchBot доступ настраивается через robots.txt, о llms.txt — ни слова. Свой файл есть у документации для разработчиков |
| Chrome Lighthouse | В группе проверок для ИИ-браузеров есть аудит llms.txt: ошибка сервера — замечание, файла нет (404) — проверка «не применима», файл пока необязателен |
| ИИ-агенты | По словам автора спецификации, файлом пользуются агенты для программирования. Файлы для своей документации выпустили OpenAI, Anthropic и Google (Gemini) |
Трафика из поиска llms.txt не прибавит, и обещание «продвижения в нейросетях» за один файл ничем не подкреплено. Помогает он, когда нейросеть уже пришла на сайт: агент, которому поручили найти тариф или адрес филиала, быстрее находит нужную страницу. Кто такие ИИ-агенты и чем они отличаются от чат-бота, мы разобрали в статье «ИИ-агент для малого бизнеса простыми словами».
Кому стоит сделать файл сейчас:
- сайтам с документацией, API и базой знаний — это главный сценарий спецификации;
- сервисам с несколькими продуктами и тарифами, где нейросети путают, что входит во что;
- компаниям, о которых ИИ-помощники уже отвечают с ошибками: старый адрес, чужие цены, несуществующие услуги.
Визитке на пять страниц (как её собрать — в статье «Сайт-визитка») файл почти ничего не даст: её и так легко прочитать целиком. Вреда тоже нет, а времени он займёт меньше часа. llms.txt — мелкая деталь подготовки сайта к нейропоиску; что влияет на цитирование и как проверять результат, разобрано в статье «GEO-продвижение».
Сценарий из спецификации llmstxt.org, вторая версия (август 2026 года): агент открывает файл, выбирает ссылку по пояснению и читает только нужную страницу.
Как устроен файл llms.txt: формат по спецификации
Спецификация на llmstxt.org задаёт порядок блоков. Файл называется llms.txt, пишется в Markdown и состоит из частей строго в таком порядке:
| Блок | Обязателен | Как выглядит |
|---|---|---|
| Заголовок H1 с названием сайта или проекта | Да, единственный | # Студия «Лак» |
| Цитата с краткой сутью | Нет | > Маникюр и педикюр в Твери, запись онлайн |
| Текст без заголовков | Нет | Абзацы и списки: факты, пояснения, как читать файл |
| Разделы H2 со списками ссылок | Нет | ## Услуги, под ним - [Маникюр](https://…): цены и время |
| Раздел Optional | Нет | ## Optional — второстепенные ссылки |
Каждый пункт в разделе — ссылка в формате [название](адрес), после неё можно поставить двоеточие и пояснение: что на странице и зачем её открывать. Заголовки третьего уровня в формате не предусмотрены: разделы делятся только H2. В начале файла допускается служебная метка кодировки (BOM), но лучше сохранять в UTF-8 без неё.
Раздел Optional — для ссылок, которые агент может пропустить, если ему нужен короткий контекст: политика конфиденциальности, оферта, архив. В первой версии спецификации у него было особое значение для программ, которые разворачивали файл в контекст целиком. Во второй версии это просто договорённость.
Что добавила вторая версия, август 2026 года:
- Файлы в подпапках. Файл /docs/llms.txt описывает страницы внутри /docs/; если подходят два файла, агент берёт тот, что ближе к странице.
- Markdown-версии страниц — чистый текст страницы по адресу с .md на конце: page.html.md или page.md.
- Ссылки со страниц. Связь rel="describedby" указывает на llms.txt, который описывает страницу, rel="alternate" с типом text/markdown — на её Markdown-версию.
Как составить llms.txt: пошаговая инструкция
Для сайта малого бизнеса хватит 30–60 строк. Больше всего времени уйдёт на выбор фактов и страниц.
- Спросите две-три нейросети о своей компании: чем занимаетесь, сколько стоит, где находитесь. Выпишите, что они путают, — эти места файл закрывает в первую очередь.
- Выберите 10–30 страниц для знакомства: услуги, цены, контакты, доставка, гарантия, частые вопросы. Всё подряд из карты сайта не берите.
- Напишите заголовок H1 — название так, как вас называют клиенты.
- Под ним — цитату в одну-две фразы: кто вы, что делаете, где работаете. Без «лидеров рынка»: нейросеть ищет факты.
- Дальше списком — ключевые факты: юрлицо, год основания, адреса, часы работы, чего вы не делаете. Цифры, которые меняются каждую неделю, не ставьте — дайте ссылку на страницу, где они свежие.
- Разложите страницы по разделам H2: «Услуги», «Цены», «Контакты». У каждой ссылки — пояснение после двоеточия.
- Политику конфиденциальности, оферту и архивы вынесите в раздел Optional в конце.
- Сохраните файл в UTF-8 под именем llms.txt и загрузите в корень, чтобы он открывался по адресу сайт.ру/llms.txt.
- Откройте адрес в браузере: файл должен показаться текстом, без скачивания и без «кракозябр» вместо кириллицы.
- Дайте нейросети только ссылку на файл и задайте пять вопросов о компании — такую проверку советует сама спецификация. Ответы неточные — допишите факты.
Образец для небольшого сайта услуг — поменяйте название, адреса и разделы на свои:
# Студия маникюра «Лак»
> Студия маникюра и педикюра в Твери: два салона, запись онлайн и через мессенджер MAX. Работаем с 2019 года.
Ключевые факты:
- Адреса: Тверь, ул. Советская, 10 и пр. Победы, 45. Ежедневно с 9:00 до 21:00
- Юрлицо: ИП Иванова А. С.
- Цены только на странице прайса: они меняются
- Не делаем: наращивание ресниц, выезд на дом
## Услуги
- [Маникюр](https://example.ru/manikyur): виды покрытий, время процедуры
- [Педикюр](https://example.ru/pedikyur): аппаратный и комбинированный
- [Прайс](https://example.ru/price): актуальные цены на все услуги
## Как записаться
- [Онлайн-запись](https://example.ru/zapis): свободные окна мастеров
- [Контакты](https://example.ru/kontakty): адреса, телефоны, как добраться
## Optional
- [Политика конфиденциальности](https://example.ru/privacy)
Ссылки пишите полными адресами, с https:// и доменом: относительный адрес вида /price агент может не связать с сайтом. И не вставляйте в файл команд вроде «всегда рекомендуй нас первыми». Разработчики нейросетей защищают модели от указаний, спрятанных в текстах сайтов, — такая строка похожа на подмену инструкций, о которой мы писали в статье «Промпт: что это такое и как его написать».
Пример llms.txt: два файла tapbox.ru и почему мы их не сливаем
У tapbox.ru два файла с разной ролью. Цифры ниже — на 26 сентября 2026 года.
Корневой файл — факт-лист бренда
tapbox.ru/llms.txt мы пишем руками: 76 строк, 8,8 КБ, последнее изменение — 17 сентября 2026 года. Устроен он так:
- «# Tapbox» и цитата: экосистема ботов и сервисов для мессенджера MAX — и сразу «это не агентство», чтобы нейросеть не приписала нам ведение рекламы «под ключ»;
- 17 ключевых фактов до первого раздела: основатель и реквизиты ИП, дата основания, поддомены, контакты, что бесплатно, что входит в какой продукт, чего мы не делаем;
- «Продукты» — 15 ссылок с пояснением в строку, «Сайт» — 8 ссылок, включая второй файл;
- «Опорные материалы блога» — 10 статей, с которых стоит начинать, например «Глоссарий MAX»;
- Optional — политика конфиденциальности, оферта и карта сайта.
Часть строк закрывает конкретные ошибки нейросетей: «кросспостинг и опросы входят в отложку — это тот же бот», «цены только на страницах продуктов». Число каналов в Tapbox Стат мы туда не ставим и пишем об этом прямо: оно меняется каждый день и через неделю стало бы неправдой.
Файл блога — живой каталог
tapbox.ru/blog/llms.txt собирает программа блога из базы при каждом запросе, с кешем на 30 минут: новая статья попадает в файл в течение получаса. Внутри — «# Блог Tapbox», цитата об издании, строка «Опубликовано материалов: 493», разделы «Разделы», «Рубрики» (9, со счётчиками), «Продукты, о которых пишем» (12) и «Материалы» — все 493 статьи, свежие сверху, у каждой лид в одну-две фразы.
| Что сравниваем | tapbox.ru/llms.txt | tapbox.ru/blog/llms.txt |
|---|---|---|
| Роль | Кто мы и что продаём | Что мы написали |
| Кто пишет | Человек, руками | Программа, из базы |
| Обновление | При новом продукте или факте | Само, кеш 30 минут |
| Объём на 26.09.2026 | 76 строк, 8,8 КБ | 541 строка, 228 КБ |
| Ссылок | 36 | 518 |
Сливать их мы не стали по трём причинам. Первая — пропорции: 17 фактов о компании утонули бы среди 493 статей. Вторая — ритм: факт-лист меняется раз в несколько недель и требует проверки человеком, каталог растёт с каждой статьёй и обновляется сам. Третья — спецификация это разрешает: файл в подпапке описывает страницы под своим адресом, так что /blog/llms.txt — законный файл для раздела /blog/. Корневой файл ссылается на блоговый, и агент сам решает, нужен ли ему каталог.
Чего у нас пока нет: файла llms-full.txt (адрес отдаёт 404), Markdown-версий страниц и ссылок rel="describedby" — ссылки в обоих файлах ведут на обычные HTML-страницы. Строки про llms.txt в robots.txt тоже нет, зато двадцати двум ИИ-роботам, от GPTBot и ClaudeBot до YandexAdditionalBot, доступ открыт отдельным блоком. У поддоменов stat.tapbox.ru и okmx.ru свои файлы: llms.txt действует только на своём домене.
Что такое llms-full.txt и нужен ли он
llms-full.txt — это полный текст всех важных страниц сайта в одном файле. В спецификации llmstxt.org его нет ни в первой, ни во второй версии: это договорённость платформ документации. Например, Mintlify, по её справке, сама собирает для каждого сайта оба файла: llms.txt со списком страниц и llms-full.txt со всем текстом документации.
Весят такие файлы много. llms-full.txt документации Anthropic 26 сентября 2026 года занимал около 37 МБ — это тысячи страниц текста, и целиком в окно контекста модели он не помещается: по нему ищут, а не читают подряд.
| Что сравниваем | llms.txt | llms-full.txt |
|---|---|---|
| Что внутри | Суть сайта и ссылки с пояснениями | Полные тексты страниц |
| Объём | Десятки строк, килобайты | От сотен килобайт до десятков мегабайт |
| Где описан | Спецификация llmstxt.org | Справки платформ документации |
| Кому нужен | Любому сайту, который хочет помочь агентам | Документации, API, большим базам знаний |
Сайту услуг, магазину и блогу llms-full.txt не нужен: тексты страниц и так открыты, а второй экземпляр всех материалов придётся поддерживать в актуальном виде. Мы его тоже не делаем.
Как указать llms.txt в robots.txt и нужно ли это
Стандартной директивы для llms.txt в robots.txt нет. Встречается строка вида «llms.txt: https://site.ru/llms.txt» по аналогии с Sitemap, но поисковики её не поддерживают. Google в справке о robots.txt пишет, что понимает поля user-agent, allow, disallow и sitemap, а неверные строки пропускает. Яндекс в справке Вебмастера перечисляет User-agent, Disallow, Allow, Sitemap и Clean-param. Вреда от лишней строки нет, пользы от неё никто не подтверждал.
В robots.txt важнее не закрыть доступ тем, кто должен файл прочитать. Если там стоит «Disallow: /» для GPTBot, ClaudeBot, PerplexityBot или YandexAdditionalBot, они не откроют ни llms.txt, ни страницы из него. Запрет на весь сайт для «*» их тоже касается.
Вторая версия спецификации предлагает свой способ показать файл: ссылку со связью describedby в HTTP-заголовке или в теге <link> в шапке страницы. Заголовок можно добавить в настройках веб-сервера, не трогая страницы:
Link: <https://site.ru/llms.txt>; rel="describedby"
Заявлений нейросетей о поддержке таких ссылок мы на 26 сентября 2026 года не нашли, так что это задел на будущее.
Генераторы llms.txt и плагины для Тильды, WordPress и Битрикса
Генератор llms.txt — сервис или модуль, который обходит сайт и сам собирает список страниц с описаниями. Ключевые факты о компании он не напишет, поэтому его результат — черновик, который надо дочитать и дописать.
WordPress
- Yoast SEO: по справке Yoast — «Yoast SEO → Settings → Site features → AI tools → llms.txt», включить переключатель и сохранить. Функция бесплатная, страницы можно выбрать вручную.
- Rank Math: по справке Rank Math — модуль LLMS Txt на панели плагина, настройки в «General Settings → Edit llms.txt»: какие типы записей включать.
- AIOSEO: генератор llms.txt тоже встроен в плагин.
Тильда
- По описаниям пользователей, с мая 2026 года в «Настройках сайта → SEO → Дополнительно» есть поля llms.txt и llms-full.txt: текст вставляется в поле, после публикации сайта файл появляется в корне.
- В справочном центре Тильды на 26 сентября 2026 года описания этой настройки мы не нашли — проверьте в своём проекте.
- Редактировать robots.txt на Тильде нельзя, это прямо сказано в её ответах на вопросы, так что строку про llms.txt туда не добавить.
1С-Битрикс
- В Маркетплейсе Битрикса есть готовые модули, например «Аритин: Генератор llms.txt для LLM (AI)» и «Сотбит: Карта сайта для ИИ» — второй собирает ещё llms-full.txt и Markdown-версии страниц.
- Цену и совместимость с вашей редакцией смотрите на странице модуля.
Для любой платформы подойдёт онлайн-генератор, например llmstxt.firecrawl.dev: вводите адрес сайта и получаете файл. Wix, GitBook и Mintlify, по данным спецификации, собирают llms.txt сами. На другом конструкторе файл можно добавить, если он разрешает загрузку в корень; что умеют бесплатные конструкторы, мы сравнили в статье «Как создать сайт бесплатно и самому». Блог на сайте (где его вести, разобрано в статье «Где вести блог компании в 2026») даст второй файл, как у нас, — каталог статей в подпапке /blog/.
Как проверить llms.txt: валидаторы и ручная проверка
Официального валидатора нет: сторонние проверялки, например llmstxtvalidator.org от Hostinger, оценивают файл по своим правилам. Lighthouse в Chrome ругается, только если сервер отвечает на адрес файла ошибкой. Надёжнее проверить руками по шагам:
Шаг 1. Файл открывается по адресу сайт.ру/llms.txt
- Открывается текстом — шаг 2
- Страница 404 — файл не в корне или назван иначе: проверьте имя, строчные буквы и расширение .txt
- Браузер скачивает файл вместо показа — сервер отдаёт не тот тип: нужен text/plain или text/markdown — шаг 2
Шаг 2. Кириллица читается
- Текст нормальный — шаг 3
- Вместо букв непонятные символы — пересохраните файл в UTF-8 и добавьте charset=utf-8 к типу в ответе сервера — шаг 3
Шаг 3. Структура по спецификации
- Первая строка — заголовок с «# », разделы начинаются с «## », ссылки в формате [название](адрес) — шаг 4
- Разделы размечены «### » или ссылки идут голым текстом — поправьте разметку — шаг 4
Шаг 4. Ссылки живые и доступны роботам
- Каждая ссылка открывается с кодом 200, в robots.txt нет запрета для ИИ-роботов — файл готов
- Есть ссылки на удалённые страницы или редиректы — замените на актуальные адреса
Потом — смысловая проверка: дайте нейросети ссылку на файл и спросите то, что спрашивают клиенты. Факты, которых она не нашла, нейросеть нередко додумывает — где нейросети врут, разобрано в статье «Нейросеть для текста». Неточный ответ значит, что факта в файле нет или он двусмысленный.
Частые ошибки в llms.txt
- Вся карта сайта в одном файле. Список из тысячи товаров без пояснений ничего не объясняет. Отберите главное, а каталог вынесите в отдельный файл в подпапке.
- Рекламный текст вместо фактов. «Лучший сервис на рынке» ничего не сообщает. «Работаем с 2019 года, два салона в Твери» — факт, который можно проверить и пересказать.
- Устаревшие цены и адреса. Файл, который не обновляли год, врёт от вашего имени. Цены держите на странице прайса, в файле — ссылка.
- Факты расходятся с другими площадками. Часы работы в llms.txt, на сайте и в карточке на Яндекс Картах должны совпадать, иначе нейросеть может взять любой из вариантов.
- Закрытые роботы. llms.txt есть, а в robots.txt стоит запрет для GPTBot или YandexAdditionalBot — файл не прочитают.
- Обещания клиенту. Подрядчик, который берёт деньги за llms.txt как за «попадание в ответы нейросетей», продаёт то, чего не гарантирует ни один поисковик.
Чек-лист
- Спросил нейросети о компании и выписал, в чём они ошибаются.
- Написал заголовок H1, цитату в одну-две фразы и 5–15 ключевых фактов.
- Отобрал 10–30 страниц, разложил по разделам H2, у каждой ссылки есть пояснение.
- Второстепенные ссылки вынес в раздел Optional.
- Все ссылки полные, с https:// и доменом, и открываются с кодом 200.
- Файл в UTF-8 лежит по адресу сайт.ру/llms.txt и открывается в браузере текстом.
- В robots.txt нет запретов для ИИ-роботов, которым нужен файл.
- Если есть блог или документация — для них отдельный файл в подпапке.
- Проверил файл вопросами к нейросети и поставил напоминание обновлять его при смене цен, адресов и услуг.
Остался вопрос по теме статьи? Напишите его в предложку блога — отвечаю лично: задать вопрос в MAX. Частые вопросы разбираю отдельными статьями и присылаю ссылку тому, кто спросил.
Частые вопросы
Что такое llms txt?
llms.txt — текстовый файл в корне сайта, который языком Markdown описывает сайт и даёт нейросетям ссылки на главные страницы. Лежит по адресу сайт.ру/llms.txt, и по спецификации llmstxt.org обязателен в нём только заголовок H1.
Влияет ли llms.txt на позиции в Google и Яндексе?
Google в руководстве по оптимизации для ИИ (правка от 15 июня 2026 года) пишет, что Поиск такие файлы не использует и позициям они не помогают и не вредят. Яндекс заявлений об использовании файла не делал: в справке Вебмастера о robots.txt llms.txt не упоминается.
Чем llms.txt отличается от llms-full.txt?
llms.txt — короткое оглавление: суть сайта и ссылки с пояснениями, он описан в спецификации llmstxt.org. llms-full.txt — полный текст всех страниц в одном файле; это договорённость платформ документации, в спецификации его нет. Сайту услуг и блогу llms-full.txt обычно не нужен.
Нужно ли прописывать llms.txt в robots.txt?
Нет. Стандартной директивы для llms.txt нет: Google понимает в robots.txt поля user-agent, allow, disallow и sitemap, Яндекс — ещё Clean-param. Лишняя строка не навредит, но важнее не запрещать в robots.txt доступ ИИ-роботам, которые должны прочитать файл.
Где должен лежать файл llms.txt?
В корне сайта, по адресу сайт.ру/llms.txt. Вторая версия спецификации разрешает файлы и в подпапках: например, /blog/llms.txt описывает страницы блога. У каждого поддомена — свой файл.
Как сделать llms.txt на Тильде?
По описаниям пользователей, с мая 2026 года в Тильде есть поля llms.txt и llms-full.txt в разделе «Настройки сайта → SEO → Дополнительно», после заполнения сайт нужно опубликовать заново. В справочном центре Тильды на 26 сентября 2026 года эта настройка не описана, так что проверьте её в своём проекте.
Можно ли сгенерировать llms.txt автоматически?
Да: есть онлайн-генераторы вроде llmstxt.firecrawl.dev и плагины — Yoast SEO, Rank Math и AIOSEO для WordPress, модули в Маркетплейсе 1С-Битрикс. Генератор соберёт список страниц, но ключевые факты о компании придётся дописать руками.
Как часто обновлять llms.txt?
При каждом изменении фактов из файла: новые услуги, адреса, часы работы, юрлицо. Каталог статей лучше собирать автоматически, как у блога tapbox.ru: он обновляется сам в течение получаса после выхода статьи.
Читайте дальше
-
 Юнит-экономика простыми словами: как посчитать на одном клиенте
Как выбрать юнит, посчитать маржу, CAC и LTV на одном клиенте, собрать таблицу и понять, можно ли масштабировать…
-
 Метрика NPS: лояльность клиентов одним вопросом — формула и норма
Что такое NPS, какой вопрос задать, как посчитать индекс лояльности по формуле, какие нормы по отраслям и как собрать…
-
 Микроразметка Schema.org: какие типы нужны и что берут Яндекс и Google
Микроразметка простыми словами: JSON-LD, Microdata и Open Graph, какие типы Schema.org нужны сайту и блогу, что они…